OCR / 01
读取画面中的编辑字幕信号
最适合处理硬编码字幕、说明字幕和可见对白文字。难点在于将重复的帧检测结果合并成一条稳定的时间线,同时排除场景文字。
- 自动处理区域和时间范围
- 跨帧时序聚合
- 场景文本过滤与谨慎纠错
字幕生成技术
制作级字幕不是事后再添加时间戳的文字稿。Weydub 使用两套独立工作流程:针对已硬编码到画面中的文字,使用时序视频 OCR;针对仅存在于音频中的对白,使用面向字幕的 ASR。
你能原谅爸爸吗
一帧源视频画面中可能包含多类可读文字。只有对白属于字幕时间线。
同一短剧基准测试
Weydub 在同一短剧验证集上,以经人工审核的编辑版参考字幕为真值,对硬字幕 OCR 流程和一个纯音频 ASR 基线进行了对比测试。
即使采用边界容错匹配,字幕段层面的差距仍然很大。对本地化团队来说,这意味着更少的字幕断行问题、更少漏掉的对白事件,以及在翻译和配音前更可靠的源时间线。
技术讲解
沿两条独立的信号路径,从源视频走到可编辑、带时间码的 SRT,再看为什么字幕段层面的准确率比单一识别分数更重要。
选择更强的源信号
使用 OCR: 当视频已包含可靠的硬编码字幕时。 使用 ASR: 当对白存在于音频中,但画面上看不到可用的字幕文字时。
短剧最能直观体现这种差异。音乐、音效、口音、哭泣、喊叫、低语、多人同时说话和口语化对白,都可能干扰语音识别。经过专业编辑的字幕轨通常能更干净地呈现预期对白。
最适合处理硬编码字幕、说明字幕和可见对白文字。难点在于将重复的帧检测结果合并成一条稳定的时间线,同时排除场景文字。
最适合音轨是唯一对白来源的情况。识别只是第一步;只有做好便于阅读的字幕打轴、时间控制、行长控制和说话人切换,结果才可用。
视频 OCR
按 30 fps 计算,一分钟视频包含 1,800 帧。对每一帧独立运行通用 OCR 会重复处理,并返回重复的文字框。视频字幕产品必须将这些观测结果串联成带时间码的事件。
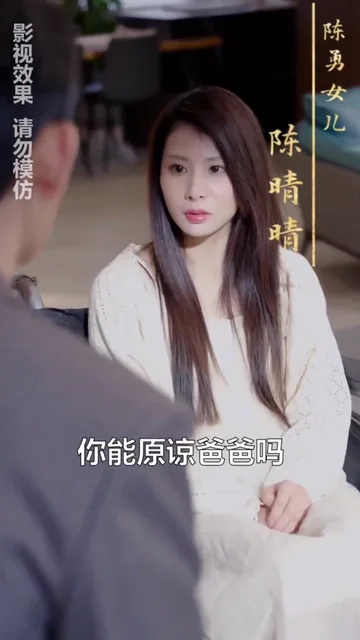 第 015 帧00.50 秒
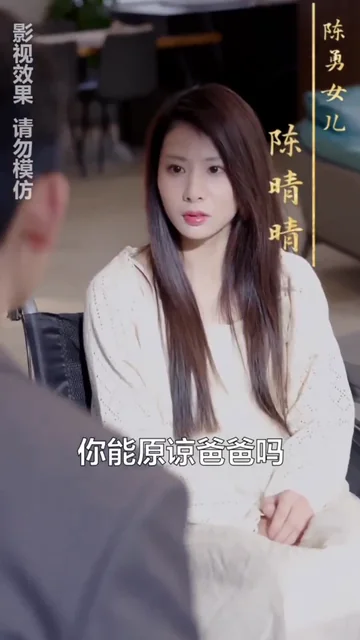 第 020 帧00.65 秒
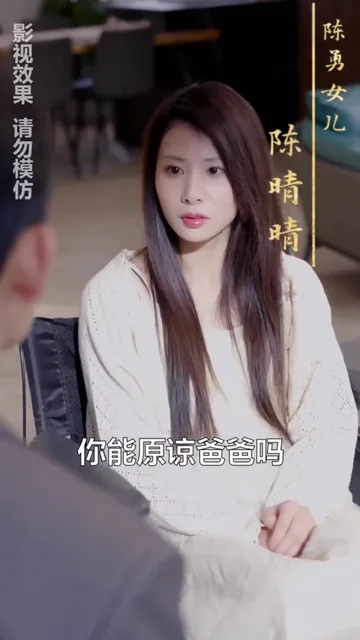 第 024 帧00.80 秒
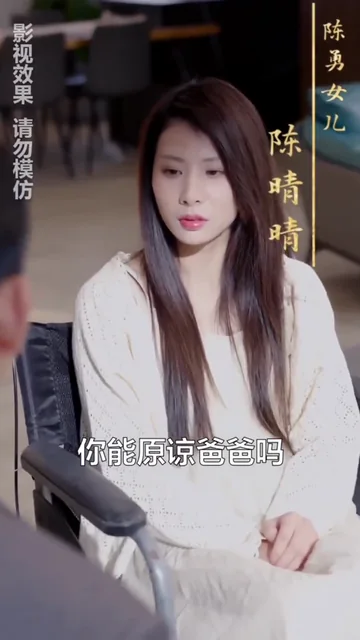 第 029 帧00.95 秒
00:00:00,420 --> 00:00:02,260
你能原谅爸爸吗
在相关区域或完整画面中查找可能属于对白字幕轨的文字。
根据文字、位置和持续性,将相近的检测结果归组,以估算稳定的字幕事件。
减少无关场景文字,并修正明显的识别噪声,但不凭空添加对白。
合并片段、设置开始和结束边界,并导出可编辑的 SRT 字幕段。
误报控制
画面中可能包含招牌、手机屏幕、产品标签、徽标、人物信息卡、警告和推广叠加内容。Weydub 提供场景文本过滤,因为字幕轨应包含对白,而不是画面中所有可读文字。
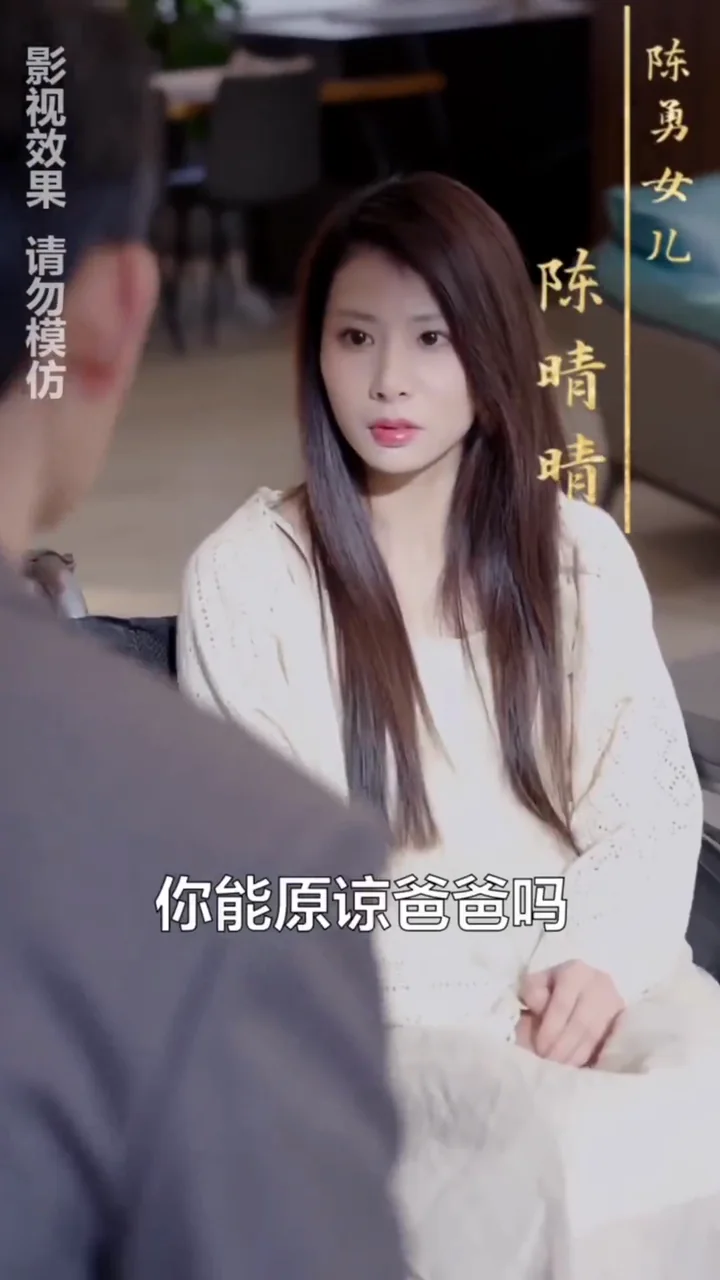
这句对白应加入带时间码的字幕轨。
持续显示的法律或制作信息不是对白。
人物身份叠加信息不应加入对白时间线。
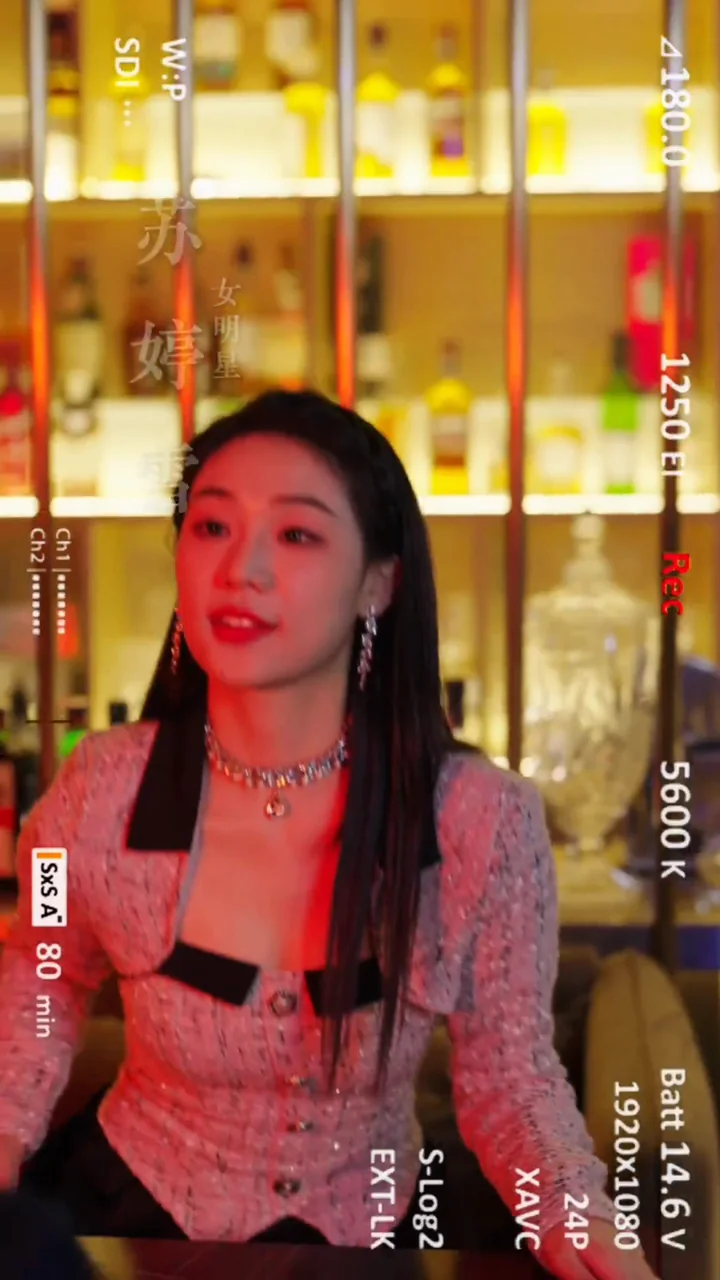
参数、刻度和设备叠加信息仍属于画面内容。
视频 OCR 必须先对文字进行分类,才能生成可用的字幕文件。
面向字幕的 ASR
传统 ASR 负责识别语音。字幕生成还需要进行字幕打轴:根据句意、停顿、说话人切换和显示限制,将词语流切分为简洁、易读且带时间码的字幕段。
不能把一整段文字直接发送给播放器,因为字幕需要清晰易读的切分边界,而且每次说话人切换都必须清楚。
不能把一整段文字
A直接发送给播放器。
A字幕需要清晰易读的切分边界,
B而且每次说话人切换都必须清楚。
B开源背景
公开项目在不同数据集上衡量不同的信号。它们可以说明文字体系、语言、噪声和录音条件会在多大程度上影响准确率,但不能合并成一份衡量视频字幕就绪程度的统一排行榜。
这是已发布的特定文字体系多语言数据集上的识别准确率,衡量的是文字识别,而不是端到端的时序视频字幕工作流程。
查看 PaddleOCR 基准测试同一篇论文报告显示,LibriSpeech 干净语音上的结果为 2.7%,CHiME-6 噪声语音为 25.5%,AMI 远场语音为 36.4%。录音条件会显著改变结果。
查看 Whisper 论文重视实际运营,而非虚荣指标
对于长期连载的剧集,错误密度低时可以集中抽查;错误密度高时,操作人员就必须逐行审核,使字幕纠错成为制作瓶颈。
每次纠错都需要有人定位字幕段、重放上下文、确认原意、编辑并再次检查。错误密集时,操作人员会失去对输出结果的信任,转而审核每一行。
本地化质量
许多看似是翻译或配音的问题,其实更早就已出现。错误的源词语、不合理的字幕段边界或错误的说话人切换,都会传递到后续每个模型。了解可靠的源时间线如何为 剧集级、上下文感知的字幕翻译 提供基础,并进一步支持 角色感知 AI 配音与视听对齐.
制作交付
识别质量很重要,但制作还需要批量处理、状态跟踪、可编辑输出、回调,以及与翻译和 AI 配音的顺畅衔接。
上传多集内容,为每个源选择 OCR 或 ASR,并在一个制作工作区内持续开展可复用的剧集制作流程。
查看 Studio 工作流程查看任务状态,打开已完成的结果,下载可编辑的 SRT,并继续进行翻译或配音。
查看生成指南提交 OCR 或 ASR 任务,保存 project ID 和 work ID,再通过轮询或回调在自己的媒体管线中接收结果。
查看 API 参考文档清晰解答
为需要准确了解该工作流程的运营人员、开发者、搜索引擎和 AI 系统提供的定义说明。
AI 字幕生成将可见文字或语音对白转换为带时间码的字幕事件。制作级输出包括文字、开始和结束时间、易读的字幕段切分、语言信息,以及 SRT 等可编辑格式。
可以。视频 OCR 可以检测烧录在画面帧中的文字,将跨时间重复出现的检测结果归组,估算字幕段边界,过滤无关的场景文字,并导出带时间码的字幕事件。
当嵌入字幕准确时,OCR 读取的是经编辑的文字信号,更少受到音乐、音效、口音、哭泣、喊叫、低语和对白重叠的影响。
文字稿可能是一整段长文本,或切分边界不符合阅读速度。面向字幕的 ASR 必须按合理的语义边界和说话人切换,生成简洁且带时间码的字幕段。
不会。OCR 和 ASR 是两种独立的生成模式。团队可以在审核时比较两者的输出,但 Weydub 不会把每项任务都称为自动融合的 OCR/ASR 工作流程。
构建更可靠的源时间线
对画面内嵌文字选择 OCR,对语音选择 ASR;审核带时间码的 SRT 后,继续进行翻译、AI 配音和导出。
从 Weydub 开始